Journal d’activité d’un logiciel : consigner l’utile sans tout enregistrer
Quand un utilisateur signale qu’une action a échoué, une équipe peut manquer d’indices pour comprendre ce qui s’est passé : quelle opération a été lancée, à quel moment, et avec quel résultat ? Un journal d’activité bien conçu aide à reconstituer le déroulement d’un scénario. Mal conçu, il devient au contraire une accumulation de messages difficiles à exploiter, parfois enrichie de données qu’il aurait mieux valu ne pas conserver.
Le sujet concerne aussi bien les éditeurs de logiciels que les équipes qui développent un outil métier. L’objectif n’est pas de tout tracer, mais de décider à l’avance quelles informations seront utiles pour diagnostiquer un problème, suivre une opération ou répondre à une question précise. Voici une méthode pour établir ces choix sans transformer chaque action en collecte systématique.
Partir des questions auxquelles il faudra répondre
Avant de choisir un format ou un outil, listez les situations à éclaircir. Par exemple : une importation a-t-elle été lancée et s’est-elle terminée ? Une demande a-t-elle été refusée par une règle métier ? Une modification a-t-elle été enregistrée ? À chaque question correspond un événement possible, avec un résultat et un contexte strictement nécessaires.
Cette démarche évite de commencer par « enregistrer tout ce qui passe ». Elle aide également à distinguer plusieurs besoins qui ne se confondent pas toujours : comprendre une erreur, suivre une opération métier et examiner un événement de sécurité. Ils peuvent demander des accès, des niveaux de détail et des durées de conservation différents. Si une donnée ne contribue à aucune question définie, sa présence dans le journal mérite d’être remise en cause.
Décrire les événements de façon cohérente
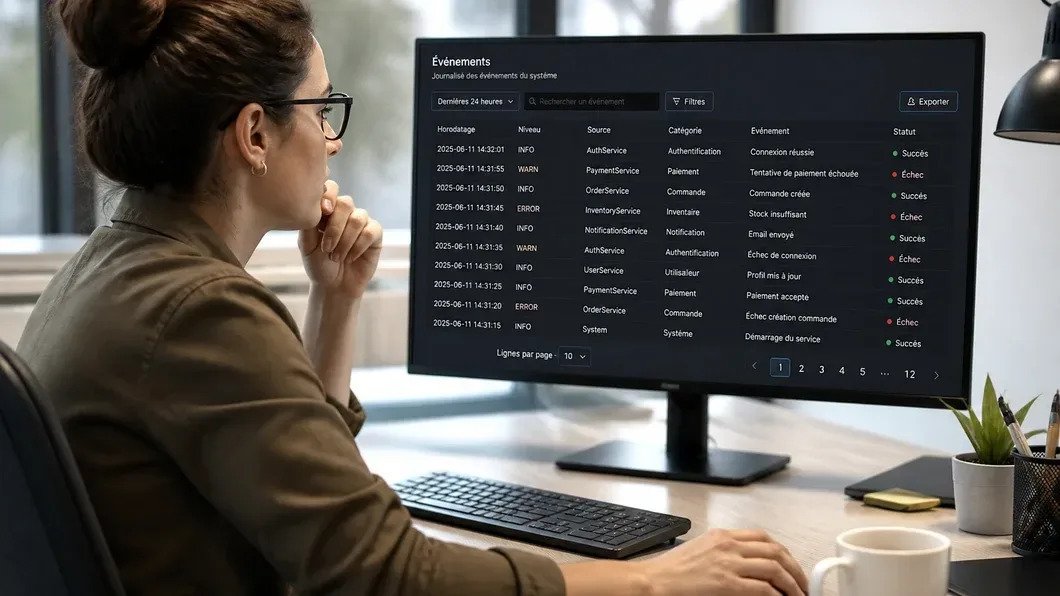
Un événement doit pouvoir être compris sans interprétation hasardeuse. Choisissez des noms stables et explicites, tels que import_demarre, import_termine ou paiement_refuse, plutôt que des libellés vagues comme « action 3 » ou « erreur ». Consignez un résultat compréhensible — succès, échec ou état intermédiaire — et, lorsque c’est utile, une catégorie d’erreur exploitable.
Un format commun facilite les recherches et les comparaisons. Pour chaque type d’événement, définissez les champs attendus, leur signification et les cas où ils sont absents. Une équipe peut, par exemple, documenter l’identifiant technique de l’opération, l’heure, le type d’événement et un identifiant de corrélation permettant de rapprocher plusieurs étapes d’un même traitement. Évitez cependant d’ajouter des champs « au cas où » sans expliquer leur utilité.
Ne pas confondre contexte et contenu sensible
Pour diagnostiquer une erreur, il est souvent plus pertinent de noter qu’un traitement a échoué à l’étape de validation que de recopier le document complet qui a déclenché l’échec. Avant d’ajouter un champ, demandez-vous s’il contient un mot de passe, un jeton d’accès, une donnée personnelle, le contenu d’un message ou une information métier confidentielle. Si la réponse est oui, cherchez d’abord une manière moins exposante d’identifier le problème : code d’erreur, identifiant technique ou valeur masquée.
Le masquage ne doit pas être une simple promesse dans la documentation. Il faut examiner ce que le logiciel envoie effectivement au journal, y compris dans les chemins d’erreur et les traces de débogage. Un message d’exception peut contenir des éléments fournis par l’utilisateur ; une requête complète peut révéler des données qui n’étaient pas destinées à être conservées. La règle pratique est de concevoir les événements pour qu’ils soient utiles même sans stocker le contenu brut.
Lire Aussi : Comment un logiciel de facturation simplifie le quotidien d’une petite entreprise
Définir qui peut consulter les traces
Un journal n’est utile que si les personnes chargées du support ou de l’exploitation peuvent y trouver les éléments nécessaires. Mais cet accès n’a pas forcément à être ouvert à toute l’équipe. Déterminez les rôles autorisés, le niveau de détail visible et la procédure à suivre lorsqu’un accès exceptionnel est nécessaire. Faites cette vérification pour les interfaces de consultation, les exports et les outils qui reçoivent les événements.
Testez les permissions avec des profils représentatifs plutôt qu’en vous contentant d’un compte administrateur. Vérifiez aussi qu’un utilisateur ordinaire ne peut pas modifier ou supprimer les traces dont une autre partie du système dépend. Ces choix relèvent de la conception du produit autant que de son exploitation : ils doivent être compris par les personnes qui développent, administrent et assistent l’outil.
Fixer une durée et vérifier le fonctionnement
Décidez combien de temps chaque catégorie de traces reste disponible et ce qui se passe à l’échéance : suppression, agrégation ou autre traitement adapté au besoin. Il n’existe pas une durée unique à appliquer mécaniquement à tous les journaux. La décision dépend de l’usage, du contexte et des exigences applicables au produit ; elle doit donc être documentée et réexaminée si cet usage évolue.
Avant la mise en service, simulez quelques scénarios concrets : opération réussie, refus attendu, interruption imprévue et reprise après erreur. Demandez à une personne qui n’a pas développé la fonctionnalité de retrouver les informations utiles. Si elle ne peut pas distinguer les étapes, si les noms restent ambigus ou si les champs sensibles apparaissent, corrigez le dispositif avant d’en dépendre pour l’assistance.
Faire du journal un contrat d’équipe
Pour chaque événement, gardez une courte fiche : sa finalité, son nom, ses champs, les rôles qui peuvent le consulter et la durée prévue. Ce document rend les changements plus lisibles lors d’une évolution du logiciel. Il permet aussi de repérer un événement devenu inutile, ou un champ ajouté sans décision explicite.
Cette méthode ne promet pas de prévenir toutes les erreurs. Elle donne plutôt un cadre pour rendre les traces compréhensibles et proportionnées au besoin. Les recommandations d’OWASP sur la journalisation applicative peuvent servir de point de départ pour examiner les événements et les informations à exclure ; elles ne remplacent pas l’analyse propre à chaque produit. Pour suivre les évolutions des logiciels et de l’intelligence artificielle, IA News Dev peut compléter la veille d’une équipe technique, sans se substituer à ses règles de conception.
